
ControlNet — что это в нейросети: поза, глубина, видео
Обновлено 7 сентября 2026 г. · Twin AI Labs
ControlNet — это нейросеть, которая добавляет структурный контроль к модели генерации изображений: вы даёте ей референс — контур краёв, карту глубины или скелет позы, — и сгенерированная картинка следует этой структуре, а /glossary/prompt задаёт стиль, цвет и детали. Именно так удерживают конкретную композицию, позу или раскладку, а не отдают всё на волю случая.

Что такое ControlNet?
ControlNet — это дополнительная нейросеть, которая позволяет управлять композицией AI-изображения с помощью второго входа рядом с текстом. Сама по себе /glossary/diffusion-модель вроде /alternatives/stable-diffusion превращает /glossary/prompt в картинку, но у вас нет надёжного контроля над точной позой, кадрированием или раскладкой — новый /glossary/seed даёт новое расположение. ControlNet это исправляет: вы даёте ему карту контроля (края, карту глубины, позу человека), и модель генерирует изображение, которое сохраняет эту структуру, а промпт решает, как оно выглядит. Метод представили в 2023 году Lvmin Zhang, Anyi Rao и Maneesh Agrawala в статье «Adding Conditional Control to Text-to-Image Diffusion Models» (arxiv.org/abs/2302.05543), которая получила Marr Prize на ICCV 2023.
Как работает ControlNet
ControlNet делает обучаемую копию половины-энкодера U-Net диффузионной модели и замораживает оригинал. Ваша карта контроля подаётся в эту копию, а её выход добавляется обратно в замороженную сеть через слои «zero convolution» — соединительные слои, веса которых стартуют с нуля, поэтому в начале обучения ControlNet ни на что не влияет и базовую модель не портит. По ходу обучения эти соединения учатся подталкивать расшумление на каждом шаге к изображениям, совпадающим с входом контроля. Поскольку исходная модель остаётся замороженной, ControlNet — это небольшой сменный модуль: один для краёв Canny, один для глубины, один для позы, каждый обучен отдельно и подгружается поверх той же базовой модели.
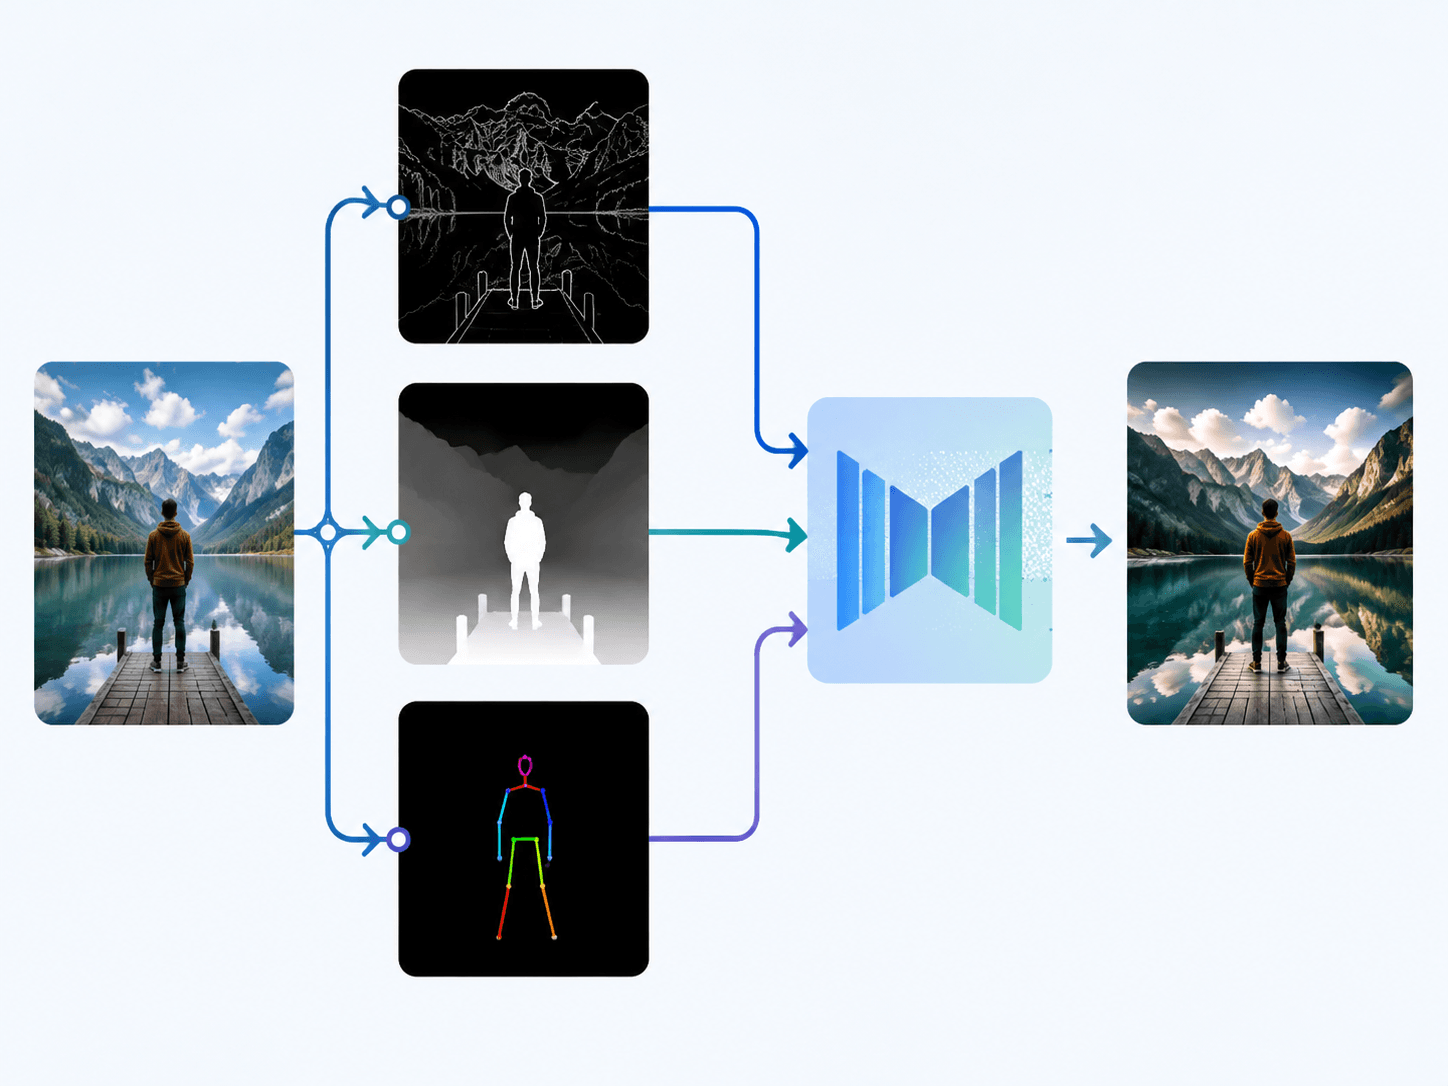
Типы контроля ControlNet
Каждый ControlNet обучен под один вид карты контроля, которую создаёт «препроцессор», извлекающий структуру из вашего референса. Самые используемые:
- Canny (края) — обводит жёсткие контуры референса, чтобы выход сохранил те же формы; самый универсальный контроль.
- Depth (глубина) — серошкальная карта, где близкое светлое, а дальнее тёмное, сохраняет 3D-раскладку и перспективу камеры.
- OpenPose (поза) — скелет-«палочный человек» головы, торса и конечностей, чтобы человека пересобрало в точно той же позе.
- Scribble / sketch — превращает грубый набросок от руки в готовое изображение по вашим линиям.
- Segmentation (сегментация) — цветовая карта областей (небо, здание, человек), которая закрепляет, где что находится.
- Lineart, soft edge, normal map, MLSD, tile — более тонкие варианты для линейной графики, архитектуры и апскейла в высоком разрешении.
ControlNet в генерации видео — что это и есть ли он там
Короткий ответ: ControlNet в строгом смысле — это модуль для диффузионных моделей изображений, и «ControlNet для видео» как отдельной кнопки в большинстве видеогенераторов нет. Но идея переносится один в один, и в видео её называют иначе — структурный контроль, motion control, pose/depth conditioning. Разница в том, что контролировать приходится не один кадр, а последовательность: карта контроля становится дорожкой (скелет позы на каждом кадре, карта глубины на каждом кадре), и задача модели — удержать не только структуру, но и её согласованность во времени, иначе поза «дрожит» от кадра к кадру. Отсюда три практических формы, в которых структурный контроль реально встречается в видео:
- Управление движением по референсу — вы даёте видео-образец движения, и модель переносит траекторию на своего персонажа. В Twin AI это Kling Motion Control.
- Image-to-video — первый кадр сам работает картой контроля: композиция, поза и кадрирование заданы вашим изображением, а промпт описывает, что дальше происходит. Так работают Kling 3.0, Veo 3.1, Seedance 2.0, Hailuo 2.3 и Wan 2.7.
- ControlNet покадрово в открытых пайплайнах — на Stable Diffusion структурный контроль применяют к каждому кадру и добавляют модуль временной согласованности; это даёт максимум контроля, но требует ручной сборки конвейера.
Как ControlNet связан с LoRA и промптом
ControlNet легко поставить рядом с другими рычагами, с которыми он работает. /glossary/prompt задаёт, о чём изображение, /glossary/cfg — насколько строго ему следовать, а /glossary/seed выбирает одно расположение из множества, но ни один из них не даёт закрепить точную позу или раскладку. ControlNet добавляет этот недостающий пространственный контроль. Он также отличается от /glossary/lora: LoRA меняет то, что модель знает (лицо, стиль), а ControlNet меняет структуру одной генерации без дообучения. Их можно совмещать — запустить LoRA собственного лица вместе с OpenPose-ControlNet, чтобы поставить это лицо в выбранную позу. Оба подключаются к тому же /glossary/diffusion-конвейеру.
Как Twin AI работает с контролем в стиле ControlNet
Twin AI даёт результаты, ради которых берутся за ControlNet — та же поза, та же композиция, ваша внешность, — без ручной настройки препроцессоров и моделей контроля. Когда вы загружаете фото в /create/photo или используете пресет /use-cases/image-generator, Twin сохраняет ваше лицо и кадрирование единообразными на всей съёмке, а шаблоны /photoshoots закрепляют позу и сцену за вас. Поскольку Twin запускает несколько моделей изображений, можно сравнить, как каждая отрабатывает один и тот же структурированный запрос — например в /compare/midjourney-vs-flux, — а ваша персональная модель в стиле /glossary/lora подключается к тому же конвейеру. Всё оплачивается российской картой или через СБП, VPN не нужен. Начните бесплатно в /create/photo.
FAQ
Что такое ControlNet в контексте генерации видео?
Сам ControlNet — модуль для моделей изображений, поэтому в видеогенераторах он обычно называется иначе: структурный контроль или motion control. Смысл тот же — задать позу, глубину или движение референсом, — но карта контроля становится дорожкой на каждый кадр, и добавляется требование согласованности во времени. На практике это управление движением по видео-референсу, image-to-video от заданного первого кадра или покадровый ControlNet в открытых пайплайнах Stable Diffusion.
Что такое ControlNet в Stable Diffusion?
ControlNet — это дополнительная нейросеть, которая управляет композицией сгенерированного изображения с помощью второго входа — контура краёв, карты глубины или скелета позы — рядом с текстовым промптом. Модель следует этой структуре, а промпт решает стиль и детали, поэтому можно закрепить точную позу или раскладку.
Как работает ControlNet?
Он копирует энкодер диффузионной модели, замораживает оригинал и подключает копию через слои «zero convolution», которые стартуют с нуля и поначалу ничего не портят. При обучении эти соединения учатся направлять каждый шаг расшумления к изображениям, совпадающим с вашей картой контроля, не меняя базовую модель.
Какие типы контроля поддерживает ControlNet?
Самые распространённые — края Canny, карты глубины, скелеты OpenPose, scribble/набросок и карты сегментации, плюс более тонкие варианты: lineart, soft edge, normal map, MLSD и tile. Каждый создаётся препроцессором, который извлекает соответствующую структуру из вашего референса.
Чем ControlNet отличается от LoRA?
LoRA меняет то, что модель знает — учит её конкретному лицу или стилю, — а ControlNet меняет структуру одной генерации, например позу или раскладку, без дообучения. Их можно использовать вместе, например LoRA лица плюс OpenPose-ControlNet.
Нужен ли ControlNet в Twin AI?
Нет. Twin AI сам сохраняет позу, кадрирование и вашу внешность, а шаблоны закрепляют композицию, так что вы получаете результат в стиле ControlNet без настройки препроцессоров и моделей контроля. Просто загрузите фото или введите промпт в /create/photo.